Al terminar esta lección
- Decidir si un proyecto necesita un Sprint de Arquitectura y de qué tamaño, usando el costo de reversión como criterio.
- Redactar contexto, problema y objetivos de modo que cada objetivo tenga métrica, línea base y una prueba que lo demuestre.
- Definir autoridad de datos, contratos de fallo, límites transaccionales e idempotencia del primer release de Nexo, y detectar en código cuándo se violan.
- Registrar riesgos con dueño y señal de activación, y justificar un plan incremental en slices verticales en lugar de capas.
8. El Sprint de Arquitectura: convertir conocimiento en un plan defendible
Para este punto del recorrido ya tenés piezas sueltas: evidencias de Nexo (EV-01 a EV-08), reglas de negocio (RN-01 a RN-07), requisitos no funcionales (NFR-01 a NFR-04), el caso de uso CU-01 en su versión final, el catálogo de criterios de aceptación AC-01 a AC-12 y los ADR-001 a ADR-006 de la lección 7. Cada pieza respondió una pregunta en su momento. Lo que todavía no sabemos es cuál manda cuando dos piezas chocan y qué se construye primero.
El Sprint de Arquitectura resuelve eso. No es una fase burocrática ni una excusa para diseñar todo antes de programar. Es un período acotado en el que convertimos discovery y especificación en un plan lo bastante sólido como para construir el primer slice sin apostar el proyecto a supuestos ocultos. Si el Sprint sale mal, el costo aparece después, en el código de un desarrollador que tomó una decisión de datos que no le correspondía tomar.
Esta lección tiene tres movimientos. Primero define qué tiene que responder el Sprint. Después recorre los conceptos que lo sostienen: autoridad, fallo, concurrencia, riesgo y slice. En cada uno aplicamos la definición al caso de Nexo, mostramos un artefacto real y señalamos el antipatrón más frecuente. La lección 8.2 muestra el mismo Sprint en la conversación con el cliente y el backlog definitivo.
8.1 Cuándo vale la pena un Sprint de Arquitectura
Problema que resuelve. Un equipo puede caer en dos extremos. En el primero diseña durante semanas y nunca escribe una línea de producción. En el segundo programa sin diseñar nada y descubre a los seis meses que el precio vive en tres lugares distintos. Antes de decidir cuánto diseño hace falta hay que saber cuánto cuesta equivocarse.
Definición operativa. Un Sprint de Arquitectura es un período acotado que convierte incertidumbres de alto impacto en decisiones defendibles para construir un primer slice. El criterio para dimensionarlo es el costo de reversión: cuánto cuesta cambiar una decisión cuando ya hay datos reales y personas operando. Un proyecto necesita un Sprint cuando tiene al menos una decisión de ese tipo que depende de evidencia todavía no resuelta.
Cómo se verifica. Para cada decisión candidata hay una pregunta concreta: si esto está mal, qué se rompe y cuánto tarda en repararse. Si la respuesta es "se rehace en una tarde", no justifica un Sprint. Si la respuesta involucra dinero, permisos, concurrencia o un sistema externo que no controlamos, sí.
Ejemplo en Nexo. Nexo tiene cuatro decisiones caras que se tocan entre sí: quién manda sobre el precio de una línea, cómo se reserva la última unidad de un SKU, qué ocurre si el proveedor fiscal no responde y cómo se evita que un pedido reintentado se duplique. Cambiar cualquiera de ellas después de que unos treinta usuarios internos operen el sistema cuesta semanas de migración de datos y de confianza. Ninguna se decide bien en una reunión de diez minutos.
Contraejemplo. La misma empresa tiene un sitio institucional con novedades y un formulario de contacto. Un Sprint de treinta páginas para ese sitio es un error de proporción. El formulario no escribe en ningún dato de negocio, no maneja dinero y no tiene concurrencia. Alguien decide el stack en una mañana, y si la decisión es mala se reemplaza sin que nadie lo note. Tratar la landing con el mismo peso que el portal B2B es el antipatrón de la burocracia: mucho documento para un riesgo que no existe.
¿Justifica un Sprint de Arquitectura?
Clasificá cada iniciativa según el costo de equivocarse en su decisión principal.
Pedidos mayoristas que descuentan stock y evalúan el crédito del cliente.
Landing institucional con formulario de contacto.
Integración con un proveedor que emite comprobantes fiscales.
Panel de solo lectura con el catálogo público de productos.
Migración de la cartera de clientes desde el ERP a una base nueva.
El mismo criterio se puede convertir en una secuencia de preguntas. Si la respuesta a la primera es no, el diseño liviano en el pull request alcanza. Si es sí, la segunda pregunta decide cuánto Sprint hace falta.
8.2 Qué tiene que responder el Sprint
Problema. Un Sprint se llena de secciones porque las plantillas tienen secciones. El resultado son documentos completos que nadie usa para decidir. La prueba de utilidad es otra: un tercero competente, que no participó de discovery, debería poder contestar en un rato qué problema se resuelve, qué queda fuera, qué reglas gobiernan el primer slice, qué riesgos cambian la arquitectura, qué datos son autoritativos, cómo se comportan los fallos, cómo se prueba y cómo se construye por etapas.
Definición operativa. Una sección del Sprint existe si responde una pregunta que alguien va a hacer. Ese alguien puede ser el cliente, un desarrollador, quien opera el sistema o un reviewer. Si una sección no responde ninguna de esas preguntas, se recorta.
La misma sección, escrita por plantilla o por pregunta
Arquitectura: diagrama de cajas con frontend, API, base de datos, cola de mensajes y caché. Tecnologías: TypeScript, PostgreSQL, Redis.
Responde qué hay en cada caja. No responde qué pasa cuando dos vendedores piden la misma unidad ni quién manda sobre el precio.
Quién manda sobre el precio de una línea: el servidor, a partir de la lista del ERP y de los acuerdos vigentes (RN-03). Qué pasa con dos pedidos por la última unidad: una sola reserva confirma y la otra recibe un rechazo sin efectos (AC-06). Qué pasa si el mismo pedido llega dos veces: se devuelve el mismo resultado, sin duplicado (RN-06).
Cada frase contesta una pregunta, y cada pregunta tiene un ID que una prueba puede citar.
Una forma práctica de auditar una sección es escribir al lado la pregunta que responde. Si no podés escribirla, la sección sobra. Las preguntas que el Sprint de Nexo tiene que poder contestar son estas:
- ¿Qué problema compramos resolver y qué métrica lo muestra?
- ¿Qué queda fuera del primer release y qué queda bloqueado por falta de evidencia?
- ¿Qué regla gobierna cada comportamiento que prometemos?
- ¿Qué fuente manda cuando dos fuentes discrepan?
- ¿Qué pasa si una integración cae justo después de un commit?
- ¿Cómo evitamos doble reserva y pedidos duplicados?
- ¿Qué riesgo nos puede obligar a cambiar la arquitectura, y con qué señal lo vamos a ver?
- ¿Qué se construye primero y cómo sabemos que funciona?
8.3 Contexto y problema: cómo se escribe sin vender tecnología
Las dos primeras páginas del Sprint son las que lee el dueño. Si suenan a folleto, el resto ya no se lee. El contexto y el problema tienen reglas distintas.
Definición operativa. El contexto es una lista de hechos observados, cada uno con su fuente (un EV-xx o una observación fechada). El problema es una consecuencia medible de ese contexto, expresada sin solución. Si el problema menciona una tecnología, todavía no es un problema: es una solución que busca un enunciado.
Nexo B2B es una distribuidora mayorista con unos treinta usuarios internos y cientos de clientes. Los pedidos llegan por WhatsApp (EV-01) y se reescriben a mano en el ERP. Muchos SKU se corrigen con una hoja de equivalencias que mantiene un vendedor (EV-02). Precio y descuento pueden venir del ERP o de acuerdos históricos en planillas (EV-04). El crédito tiene excepciones que se autorizan por audio. El depósito detecta quiebres físicos y hoy no existe una reserva transaccional. El ERP sigue siendo el maestro de productos y clientes durante la primera etapa.
La confirmación de un pedido es lenta y depende de conocimiento tácito. Puede prometer stock que no existe (EV-05) o un precio que no corresponde (EV-04). La primera entrega tiene que registrar pedidos mayoristas con reglas trazables, crédito explícito y reserva concurrente, sin reemplazar el ERP completo.
Problema: enunciado con solución o enunciado con consecuencia
Necesitamos una plataforma moderna con IA y microservicios para escalar el negocio.
No dice qué se rompe hoy ni cómo lo mediríamos. Cualquier arquitectura parece aceptable porque nadie sabe qué debe mejorar.
Un pedido de 23 códigos llegó por WhatsApp a las 10:02, se confirmó sin advertir el faltante, descubrió una diferencia de stock a las 10:31 y recién salió por logística a las 11:18 (pedido 48172).
Ahora cada decisión posterior puede preguntarse si mejora ese recorrido, y el objetivo puede medirse.
Esta diferencia tiene consecuencias prácticas. Con el enunciado bueno, el contexto ya contiene los episodios que el Sprint tiene que explicar después. Con el malo, cualquier cambio de arquitectura queda sin criterio de aceptación.
8.4 Objetivos, fuera de alcance y métricas
Problema. Los objetivos suelen aparecer en la introducción y no vuelven a aparecer nunca. Cuando llega la prueba de aceptación nadie sabe si el sistema los cumple.
Definición operativa. Un objetivo observable tiene cinco partes: el comportamiento que cambia, la métrica que lo mide, la línea base, la ventana de medición y la prueba o demo que lo demuestra. Si falta la última, el objetivo es decorativo.
En Nexo, el Sprint declara cuatro objetivos. Se escriben como datos porque después se leen desde otros artefactos.
objetivos:
- id: OBJ-1
comportamiento: reducir el tiempo desde la recepción completa del pedido hasta la confirmación comercial
metrica: mediana en minutos por pedido
linea_base: no medida; se mide en la semana de observación previa al primer slice
prueba_o_demo: medición del flujo de los slices 1 y 2 en el ambiente piloto
- id: OBJ-2
comportamiento: reducir los pedidos que necesitan intervención después de confirmarse
metrica: porcentaje de pedidos con corrección de SKU, precio o stock posterior a la confirmación
linea_base: muestra de 60 pedidos de una semana, con 37 correcciones de SKU, 14 revisiones de acuerdo de precio, 9 autorizaciones de crédito y 6 diferencias físicas
prueba_o_demo: reporte semanal construido sobre la auditoría de los slices 1 y 3
- id: OBJ-3
comportamiento: que dos pedidos no prometan la misma última unidad
metrica: pedidos confirmados por encima del disponible del depósito
linea_base: presente hoy, porque no hay reserva transaccional (EV-05); el valor aceptable es cero
prueba_o_demo: AC-06 en la prueba concurrente del slice 2
- id: OBJ-4
comportamiento: que un reintento de red no cree pedidos duplicados
metrica: requestId que produjo más de un pedido
linea_base: no medible hoy, porque el flujo actual no tiene identificador de intención
prueba_o_demo: AC-07 y el caso de conflicto de T08 en la integración del slice 2
Fijate en lo que el documento no hace: no escribe un valor objetivo para OBJ-1. Ese número sale de medir la línea base. Escribir "reducir 40 %" sin esa medición es inventar una cifra, con el mismo problema que un TTL de reserva puesto a ojo. Lo que sí puede decir el Sprint es qué se mide, cuándo y quién lo recibe.
La línea base de OBJ-2 también merece atención. La muestra de 60 pedidos sirve para entender en qué se pierde el tiempo, no para medir cuánto tarda cada pedido. Usarla para afirmar un tiempo promedio es un error de categoría: esos datos no contienen tiempos.
Fuera de alcance. Un fuera de alcance es una decisión deliberada, no una lista de cosas olvidadas. Para el primer release de Nexo quedan fuera las recomendaciones con IA, el reemplazo total del ERP, la optimización automática de compras, las devoluciones complejas y el rediseño de la facturación contable. La emisión de comprobantes queda como integración posterior: el pedido sale marcado como pendiente de facturación, y la decisión se registra en la lección 8.2.
BLOCKED no es OUT. OUT significa que decidimos no incluirlo. BLOCKED significa que todavía falta evidencia o una decisión externa. El TTL de reserva (RN-07), la tolerancia Platino (RN-02), las sustituciones automáticas y el tratamiento de cheques pendientes están BLOCKED. Cada uno dice qué falta y quién lo resuelve. Un BLOCKED sin dueño tiende a olvidarse, y uno olvidado termina implementado con un número inventado.
El objetivo dice 'reducir el tiempo de confirmación'. ¿Qué le falta para ser un objetivo observable?
8.5 Autoridad de datos: quién manda sobre cada valor
Problema. Cuando dos fuentes dicen cosas distintas sobre el mismo dato, el sistema necesita un criterio y no una costumbre. En Nexo el caso de AX-442 lo muestra: el ERP tiene un precio de lista de 12.450, y una planilla de precios acordados dice 11.900 "hasta nuevo aviso". Las dos cifras pueden aparecer en la misma pantalla.
Definición operativa. La autoridad de un dato es la fuente que decide su valor cuando hay conflicto. Para cada dato hay que declarar tres cosas: quién decide, cómo llega ese valor a Nexo y qué pasa si la fuente no responde. Si dos lugares pueden decidir el mismo dato, en la práctica nadie lo decide.
En la etapa 1 la tabla de autoridad de Nexo queda así:
| Dato | Autoridad en la etapa 1 | Si la fuente no responde |
|---|---|---|
| Productos, clientes y listas base | ERP legacy | Se usan con su antigüedad visible. Nunca se presentan como datos actuales. |
| Precio aplicado a cada línea del pedido | Nexo, calculado en servidor a partir de lista y acuerdos (RN-03) | El pedido no se confirma con un precio no verificable. Resultado temporarily_unavailable. |
| Stock reservado por depósito y SKU | Nexo sobre PostgreSQL (ADR-002) | Sin base no hay reserva, así que el pedido no se confirma. |
| Exposición de crédito del cliente | Fuente de saldos vigente, con facturas no contabilizadas. El tratamiento de cheques pendientes está BLOCKED. | Si el saldo no es confiable, el pedido queda pendiente de revisión y no se aprueba. |
| Estado del pedido | Nexo | No aplica: el estado solo cambia por transiciones válidas de Nexo. |
| Permisos y cartera del vendedor | Nexo (RBAC más contexto de cartera, NFR-03) | Se deniega por defecto y el intento queda auditado. |
| Captura de la intención | Frontend, sin autoridad sobre ningún valor de negocio | El formulario reintenta con el mismo requestId. |
La fila de precio tiene una consecuencia de diseño que suele pasarse por alto. El contrato de la lección 6.1 no tiene campo de precio: el vendedor manda SKU y cantidad, y el servidor calcula. Eso no es una cortesía del frontend; es lo que hace que la autoridad sea verificable.
// Contrato de la lección 6.1. El cliente no envía precio, crédito ni estado.
export type CreateOrderCommand = {
requestId: string; // identifica la intención (RN-06)
sellerId: string; // lo fija el servidor desde la sesión
clientId: string; // identidad autenticada o selección autorizada
items: Array<{ sku: string; quantity: number }>; // sin unitPrice (RN-03)
deliveryMethod: "pickup" | "delivery";
preferredDepositId?: string; // preferencia del cliente, no orden de reserva
};
El antipatrón aparece cuando alguien agrega el precio "para comodidad" del frontend. Una línea como la siguiente parece inofensiva, y es la causa de que el pedido 48172 terminara con tres líneas sobrescritas y un precio que no era el del ERP:
// file: src/api/orders.ts  (antipatrón: no copiar)
const line = { sku: body.sku, quantity: body.quantity, unitPrice: body.unitPrice }; // el cliente decide el precio
Cómo se verifica. Un test de aceptación concreto lo demuestra: se envía el mismo pedido con un unitPrice distinto del de lista y se comprueba que la línea guardada tiene el precio calculado en el servidor. Esa es la prueba de AC-04, y falla exactamente cuando alguien acepta el precio del body. Si el test no existe, la autoridad es una intención y no una propiedad del sistema.
¿Quién es autoridad de este dato?
Elegí la fuente que decide el valor en la etapa 1. Si el dato está en el mundo físico, elegí esa categoría.
Precio de lista de AX-442 en el ERP.
Precio aplicado a una línea de un pedido ya confirmado.
Estado PENDIENTE_AUTORIZACION de un pedido.
Precio que el vendedor escribe en la pantalla antes de enviar.
Unidades que el operario cuenta en el estante.
Código y datos del cliente en el maestro.
El flujo completo de datos se entiende mejor como un diagrama. La autoridad aparece en las flechas: qué entra, qué se confirma y qué se deja pendiente para el worker.
8.6 Contratos de fallo: qué queda verdadero cuando algo sale mal
Problema. Un sistema no se evalúa por el camino feliz. Se evalúa por lo que queda verdadero cuando un paso falla. En Nexo el caso más delicado es el comprobante fiscal: el pedido ya está confirmado en la base cuando el proveedor fiscal responde, o no responde.
Definición operativa. Un contrato de fallo declara, para cada punto de falla externo o concurrente, cinco cosas: qué efecto ya ocurrió, qué estado ve el usuario, qué se reintenta y con qué clave, qué se audita y cómo se reconcilia lo que quedó a medias. Si una integración no tiene ese contrato, no está diseñada, aunque el diagrama tenga una flecha hacia ella.
Esto conecta con las dos garantías del CU-01. La garantía mínima dice qué debe seguir siendo cierto aunque falle todo: ante un error antes del commit no queda pedido parcial, débito ficticio ni reserva huérfana. La garantía de éxito dice qué debe ser cierto al terminar bien: existe un único pedido para la intención, con precios trazables y reservas coherentes. El contrato de fallo es la versión operativa de ambas para cada integración.
El caso del proveedor fiscal se entiende en una secuencia. Fijate que el commit ocurre antes de cualquier llamada externa, y que el reintento usa la misma clave:
Los contratos de fallo de Nexo se resumen en la tabla siguiente. Cada fila es una decisión que una prueba puede verificar.
| Punto de falla | Qué ocurrió ya | Lo que ve el usuario | Reintento y reconciliación |
|---|---|---|---|
| Falla al persistir antes del commit | Nada. No hay pedido, reserva ni registro de idempotencia. | Error reintentable. Ningún número de pedido. | Nuevo intento con el mismo requestId (AC-10, T09). |
| Corte de red después del commit y antes de la respuesta | El pedido existe. El cliente no lo sabe. | Al reintentar recibe el mismo pedido (confirmed), no uno nuevo. | Idempotencia por requestId (AC-07, RN-06). |
| Proveedor fiscal caído después del commit | El pedido es válido y está confirmado. | Pedido visible como pendiente de facturación. | Worker con la misma clave hasta confirmar. El intento queda auditado (NFR-04, AC-12, T12). |
| Worker de preparación caído | El pedido está confirmado y la intención quedó en el outbox. | Pedido confirmado con handoff pendiente, visible para operaciones. | El outbox reintenta al volver el worker (AC-11). |
| Sincronización del ERP atrasada | Los maestros locales pueden estar viejos. | Si no hay señal confiable de precio, temporarily_unavailable con dependencia master_data. | Medir el lag, definir el umbral operativo y el fallback (RSK-02). |
El mismo contrato se escribe como artefacto para que el equipo lo revise y el agente de la lección 9 lo pueda leer. No es un documento de arquitectura adicional: es el contrato de una integración.
integracion: proveedor-fiscal
tipo: externa, asincrona, desde el worker
alcance_primer_release: integracion posterior; el contrato de fallo se define ahora
punto_de_commit: pedido confirmado y la intencion fiscal en el outbox, en la misma transaccion
clave_idempotencia: identificador del pedido y tipo de comprobante
reintentos: con la misma clave hasta confirmacion; el intervalo no se fija en el Sprint
estado_visible: pendiente_de_facturacion
si_la_respuesta_se_pierde: consultar por la clave antes de volver a emitir
auditoria: cada intento con clave, instante y resultado
pruebas: T12 contra fake con exito, timeout antes y despues de procesar, y error permanente
bloqueado:
- detalle real de la API del proveedor (SPK-01, dueño: lider tecnico)
Un detalle del ejemplo importa mucho. El intervalo entre reintentos no se fija en el Sprint, porque depende de cuánto tarda el proveedor en recuperarse, y eso es una medición. Lo que sí se fija es la clave, porque sin clave ningún intervalo evita duplicados.
Ordená lo que pasa cuando el proveedor fiscal no responde
Usá las flechas para ordenar los pasos desde el commit hasta la reconciliación.
- Posición 1 de 5: La respuesta se pierde y el worker no sabe si el comprobante se emitió.
- Posición 2 de 5: El worker reintenta con la misma clave y el proveedor devuelve el comprobante ya emitido.
- Posición 3 de 5: El worker toma la intención y llama al proveedor con la clave de idempotencia.
- Posición 4 de 5: El worker marca el pedido como facturado y deja el intento auditado.
- Posición 5 de 5: La transacción local confirmó el pedido y dejó la intención fiscal en el outbox.
Antipatrón. La frase "si falla, reintentamos" no es un contrato. Sin clave, un reintento puede emitir dos comprobantes. Sin estado visible, el vendedor no sabe si el pedido está confirmado. Sin auditoría, nadie puede reconstruir qué pasó el martes a las 11:03, cuando el proveedor no respondió. La prueba de que un contrato existe es que cada celda de la fila puede citarse en un test.
8.7 Concurrencia, consistencia e idempotencia
Problema. Dos pedidos llegan al mismo tiempo por la última unidad de un SKU. Si ambos leen "disponible = 1" antes de que alguno escriba, los dos se confirman y el depósito promete algo que no existe. Es el caso de EV-05 y de la regla RN-05.
Definición operativa. RN-05 es un invariante: el disponible de un depósito y un SKU, calculado como onHand menos reserved, nunca puede ser menor que cero. Un invariante no se cumple por buena intención: se cumple cuando el chequeo y la escritura son una sola operación, o cuando la base de datos hace imposible la violación. La idempotencia es el complemento: una intención repetida devuelve el mismo resultado, y una intención distinta con el mismo identificador produce conflicto (RN-06, ADR-005, con el fingerprint de ADR-006).
El antipatrón es tan común que conviene verlo en código:
// file: src/adapters/stock-antipatron.ts (antipatrón: leer y después escribir)
const row = await db.query("select available from stock where sku = $1", [sku]);
if (row.available >= qty) {
await db.query("update stock set available = available - $1 where sku = $2", [qty, sku]);
}
Entre el select y el update hay una ventana. Dos transacciones pueden pasar el if con el mismo valor y descontar dos veces. Ningún test secuencial lo detecta, porque en secuencia el código funciona bien. Por eso el Sprint pide una prueba concurrente, no solo unitarias.
La alternativa es mover la condición dentro de la escritura. La decisión de reserva usa una actualización condicional sobre el stock por depósito, sin Redis ni colas externas:
UPDATE stock_level
SET reserved = reserved + $3
WHERE product_id = $1
AND warehouse_id = $2
AND on_hand - reserved >= $3;
-- 0 filas afectadas: el adaptador devuelve InsufficientStock
PostgreSQL evalúa la condición sobre la fila una vez que la tiene bloqueada. Si la otra transacción ya tomó la unidad, el segundo update no afecta filas y la reserva se rechaza sin efectos. Esa es la prueba de AC-06, y el Sprint la exige en el checkpoint de persistencia real.
Chequear y después escribir, o escribir con la condición adentro
El código lee el disponible, decide en la aplicación y escribe después. Funciona en pruebas secuenciales y falla con dos requests simultáneos.
Síntoma: un pedido confirmado y un depósito que no tiene la mercadería. Causa: la decisión vive fuera de la transacción que la protege.
La base evalúa la condición y modifica la fila en un solo paso. El resultado es una afectación de cero o una fila, y el adaptador lo traduce a reserva o rechazo.
Síntoma esperado: una de las dos reservas recibe InsufficientStock. Eso es el comportamiento correcto y no un error.
Con la idempotencia pasa algo parecido. El identificador de la intención no alcanza por sí solo: hace falta comparar también el contenido. Dos llamadas con el mismo requestId y el mismo contenido son la misma intención. Dos llamadas con el mismo requestId y otro contenido son un error del cliente o un ataque, y no pueden producir un segundo efecto.
| requestId | Contenido (fingerprint) | Resultado |
|---|---|---|
| nuevo | cualquiera | se crea el pedido y la reserva en la misma transacción |
| ya usado | igual | se devuelve el mismo pedido, sin efecto nuevo |
| ya usado | distinto | conflict, sin ningún efecto |
El fingerprint se calcula sobre el cliente, el depósito preferido y las líneas normalizadas por SKU y cantidad, y no sobre el tracing ni sobre el orden de los campos. Un hash del JSON completo es una trampa: dos requests iguales en contenido pero distintas en la marca de tiempo del header darían conflicto.
8.8 Seguridad, observabilidad y despliegue
Problema. Quién puede hacer qué, y cómo nos enteramos cuando algo se rompe, son preguntas que el cliente y operaciones van a hacer el primer día. Un Sprint que no las contesta deja a seguridad y observabilidad para "después", y después casi nunca llega.
Definición operativa. Para seguridad, el Sprint declara tres cosas: quién puede operar sobre qué (RBAC más contexto de cartera), qué acción requiere un permiso separado y motivo obligatorio, y qué queda registrado en un audit log. Para observabilidad, declara las métricas que responden a los objetivos y las alertas que avisan de fallos que afectan el negocio, no de cada excepción controlada.
En Nexo, un vendedor de la cartera A que intenta confirmar un pedido del cliente de la cartera B recibe una denegación sin datos del cliente y el intento queda auditado (T10 y NFR-03). Autorizar una excepción de crédito es otro permiso, con motivo obligatorio y registro de quién, cuándo y para qué pedido (NFR-02). Ningún rol general lo incluye.
Las métricas se derivan de los objetivos y de los riesgos. Hay una trampa: la métrica de reservas expiradas parece obvia, pero solo tiene sentido cuando exista una política de expiración validada. Mientras RN-07 esté BLOCKED, esa métrica no se publica, porque mediría un comportamiento que todavía no existe.
Alertas sobre cada excepción controlada generan ruido, y el ruido entrena a ignorar las alertas. Una alerta útil responde a una pregunta de negocio: ¿hay pedidos confirmados sin handoff a preparación desde hace más de lo tolerado? ¿Hay intenciones fiscales envejeciendo en el outbox? ¿El lag del ERP superó el umbral operativo?
El despliegue del primer release sigue la figura 10. La topología es simple a propósito: no hay un atributo de calidad que justifique más distribución. Los nodos son el cliente web, una aplicación modular que contiene la API y los casos de uso, un worker que procesa el outbox y las integraciones, la base PostgreSQL y las integraciones externas. El estilo es el monolito modular de ADR-001, con el worker separado de ADR-003.
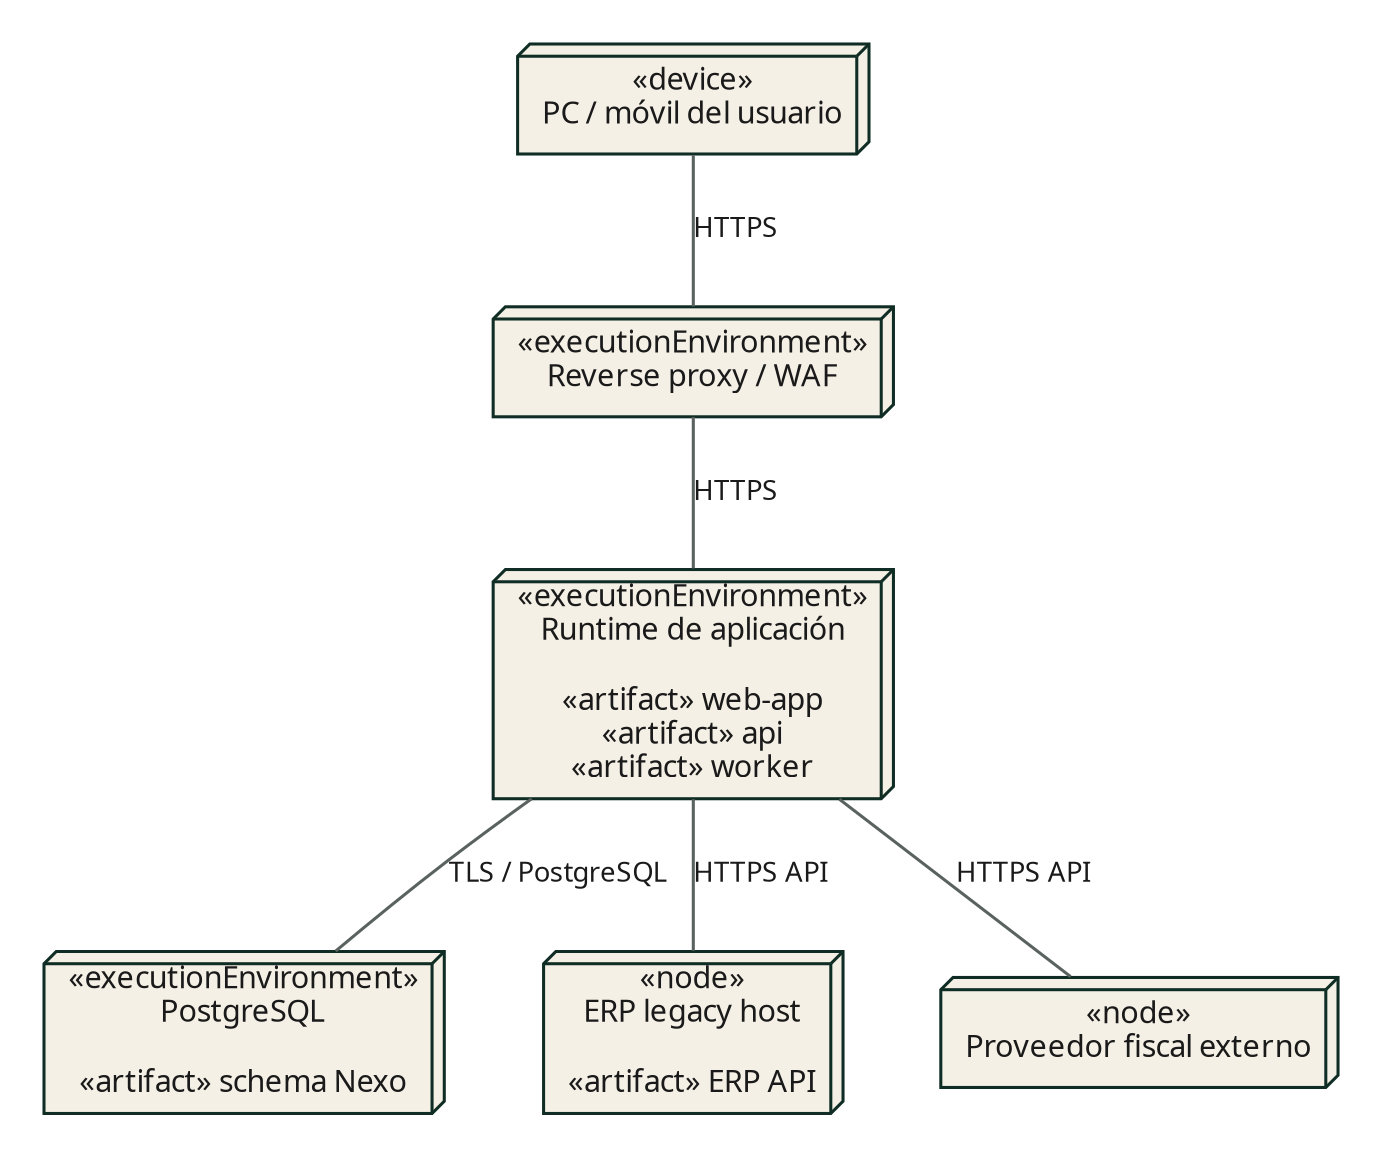
Una vista conceptual del mismo despliegue ayuda a leer la figura en una sola pasada:
Lo que no aparece en el diagrama también es una decisión. No hay servicio de catálogo separado, no hay servicio de crédito y no hay cola externa para la consistencia del stock. Si alguien lo propone en la revisión, la respuesta es el ASR que lo justificaría, no la preferencia por la arquitectura de moda.
8.9 Riesgos con señal de activación
Problema. La tabla de riesgos de la mayoría de los proyectos tiene una columna que dice "puede fallar". Eso no sirve para monitorear, no sirve para decidir y no tiene dueño. Cuando el riesgo se materializa, nadie lo reconoce porque nunca se definió cómo se vería.
Definición operativa. Un riesgo tiene cinco partes: la incertidumbre concreta, el impacto si ocurre, la probabilidad cualitativa, la mitigación que se aplica desde ya y la señal de activación, que es un hecho observable que avisa que el riesgo está pasando. Además tiene un dueño. Un BLOCKED sin dueño es un riesgo que nadie va a mirar.
Los riesgos del primer release de Nexo, con su señal y su dueño, quedan así:
| ID | Riesgo o unknown | Impacto | Mitigación o gate | Señal de activación | Dueño |
|---|---|---|---|---|---|
| RSK-01 | TTL de reserva sin validar (RN-07, BLOCKED) | Puede congelar stock o liberar mercadería reservada | Parametrizar sin valor fijo. Medir en la primera semana cuánto esperan los pedidos pendientes de autorización. | Pedidos pendientes que superan el tiempo que tolera el depósito, o reclamos por stock reservado | Depósito (Sergio) y responsable comercial |
| RSK-02 | Lag del ERP en maestros y listas | Precio o stock base obsoleto | Medir el lag, fijar un umbral operativo y definir el fallback temporarily_unavailable | Lag por encima del umbral durante más de una ventana de medición | Responsable del Desarrollo |
| RSK-03 | Acuerdos de precio inconsistentes o sin vigencia (EV-04) | Precio incorrecto en pedidos confirmados | Normalizar la fuente, fijar precedencia explícita y dejar pendiente de revisión comercial lo que no tiene vigencia validada | Pedidos cuyo precio no coincide con la planilla vigente | Responsable comercial |
| RSK-04 | Quiebre físico durante la preparación (U-05) | La reserva lógica no coincide con el estante | Flujo de excepción y ajuste de reserva con auditoría (CU-04) | Diferencias entre registro y conteo en el depósito | Depósito (Sergio) |
| RSK-05 | Proveedor fiscal caído o respuesta perdida | Pedido confirmado sin comprobante, o comprobante duplicado sin clave | Outbox, clave de idempotencia, estado visible y reconciliación | Intenciones fiscales pendientes que envejecen en el outbox | Administración (Laura) y Responsable del Desarrollo |
| RSK-06 | La reserva concurrente es más compleja de lo previsto | Retraso del slice de reserva y del resto del plan | Prueba concurrente temprana en el checkpoint C, antes de construir el boundary | La prueba concurrente falla o es inestable en dos corridas seguidas | Responsable del Desarrollo |
Los spikes son trabajo con duración máxima y criterio de salida, no construcción disfrazada. El Sprint de Nexo tiene dos: SPK-01, que prueba la idempotencia real de la API fiscal, y SPK-02, que mide la latencia del ERP y qué pasa cuando un dato desaparece o cambia de código. Ambos tienen dueño y se deben cerrar antes de estimar el slice que dependen.
El riesgo dice 'el proveedor fiscal puede caerse'. ¿Qué le falta para poder monitorearlo?
La forma de escribir un riesgo que sirve es comparar dos versiones de la misma fila:
Riesgo que no se puede vigilar y riesgo que sí
Riesgo: el proveedor fiscal puede fallar. Impacto: alto. Mitigación: tener en cuenta el caso.
No hay forma de saber cuándo empezó a pasar, ni quién tiene que actuar.
Riesgo: el proveedor fiscal no responde o pierde la respuesta después del commit. Impacto: pedido confirmado sin comprobante visible. Mitigación: outbox y clave de idempotencia desde el primer release. Señal: intenciones pendientes que superan el tiempo tolerado. Dueño: líder técnico, con administración para el seguimiento.
Cualquiera puede verificar la señal, y el dueño sabe qué hacer cuando aparece.
8.10 Plan incremental: slices verticales, no capas
Problema. El orden natural de un equipo técnico es por capas: primero el modelo de datos, después el backend, después la interfaz, y al final las pruebas. Ese orden esconde el riesgo hasta la integración, cuando ya no hay tiempo para corregirlo. En Nexo, la primera vez que se conectan precio, crédito y reserva sería la demo final, con todas las incógnitas juntas.
Definición operativa. Un slice vertical es el menor incremento que atraviesa todo lo necesario para producir un resultado observable. Tiene un actor, un resultado que alguien puede ver, las reglas que gobierna, los componentes que toca y un gate de salida. Atraviesa contrato, dominio, persistencia, una interfaz mínima y pruebas.
Hay que separar dos cosas que se confunden seguido. Los slices son unidades de valor: "Slice 2, reserva e idempotencia". Los checkpoints A a F son pasos internos de construcción de un slice. Un slice pasa por los seis checkpoints, y el orden en que se hacen es el mismo para todos:
| Checkpoint | Qué entra | Señal de que terminó |
|---|---|---|
| A. Dominio y contrato | Money, Order, Reservation, CreditDecision, comando y resultado | Tests de invariantes pasan sin base de datos |
| B. Aplicación | CreateOrderUseCase con puertos y resultados tipados | Tests con fakes controlados pasan para cada resultado |
| C. Persistencia real | Esquema, transacción, idempotencia y prueba concurrente con PostgreSQL | AC-06 pasa con base real, de forma repetida |
| D. Boundary | API, autorización contextual, validación y contract tests | Una consulta fuera de cartera responde denegación sin datos (T10) |
| E. Integraciones | Outbox, worker y adaptadores de ERP y fiscal con fallos simulados | Pruebas de rollback y de fallo externo pasan (T09, T12) |
| F. Flujo y demo | E2E selectivo, observabilidad, migración y demo | La historia de demo se ejecuta de punta a punta en el ambiente piloto |
Un ejemplo concreto: el slice 2, reserva e idempotencia, pasa por los seis checkpoints. El checkpoint A no necesita base de datos, así que se puede discutir con el equipo antes de tener esquema. El C es el que más riesgo tiene y por eso se hace temprano, antes del boundary. El resultado del slice es observable: dos pedidos compiten por la última unidad y uno recibe un rechazo, en la misma demo donde el depósito ve la reserva.
Esa estructura de dependencias se puede dibujar. Los checkpoints se ejecutan en orden, pero el valor se entrega por slice:
Un epic por capas o un slice vertical
Hacer la base de datos, después el backend, después el frontend y al final las pruebas. Cada capa tiene su gate, pero nada se puede demostrar hasta la última.
El riesgo de precio o de reserva aparece cuando ya no se puede cambiar sin rehacer tres capas.
Registrar un pedido con SKU vigentes y precio calculado en el servidor, con una pantalla mínima y pruebas de aceptación. Es chico, pero un vendedor lo puede usar y un tercero lo puede verificar.
El riesgo de precio aparece en la primera semana, cuando todavía es barato corregirlo.
El tamaño del plan también se controla. Un Sprint que propone más de siete slices probablemente está describiendo funcionalidades y no incrementos defendibles. Uno con menos de cuatro suele esconder el riesgo dentro de un único bloque grande. La lección 8.2 muestra cómo se corta el backlog de Nexo.
Vocabulario del módulo
Vocabulario de la lección 8.1
Frente
Sprint de Arquitectura
Errores frecuentes
Síntoma: el documento tiene catorce diagramas y ninguna decisión. Causa: cada sección se llenó porque la plantilla la pedía, y ninguna contesta una pregunta. Corrección: escribí al lado de cada sección la pregunta que responde. Si no podés, recortala.
Síntoma: un objetivo aparece en la introducción y nunca se menciona en las pruebas. Causa: el objetivo no tiene métrica, línea base ni prueba asignada. Corrección: completá las cinco partes del objetivo observable y asigná el test o la demo que lo demuestra.
Síntoma: el precio que ve el vendedor no es el que queda guardado en el pedido. Causa: el frontend envía unitPrice y el backend lo persiste. Corrección: quitá el campo del contrato y cubrí la regla con AC-04, que envía un precio distinto y verifica el del servidor.
Síntoma: un reintento de red crea dos pedidos. Causa: el flujo no tiene identificador de intención, o lo tiene pero no compara el contenido. Corrección: requestId obligatorio, fingerprint sobre cliente, depósito y líneas normalizadas, y la prueba AC-07.
Síntoma: dos pedidos confirman la última unidad en la prueba concurrente. Causa: la validación de disponibilidad está en la aplicación y la escritura va después, sin protección. Corrección: mover la condición dentro de la actualización, como en el ejemplo de 8.7, y repetir la prueba concurrente varias veces.
Síntoma: el riesgo dice "puede fallar" y nadie lo revisa. Causa: falta la señal observable y el dueño. Corrección: reescribir la fila con las cinco partes y asignar una persona, no un área.
Síntoma: el primer slice fue "crear las tablas" y la demo no tiene nada para mostrar. Causa: el corte fue por capas. Corrección: elegir un actor y un resultado observable, y cortar el slice alrededor de ese resultado.
Qué puede hacer el agente. Revisar el paquete del Sprint: encontrar requisitos sin prueba, decisiones sin ASR o RN de origen, términos que cambian de nombre entre secciones y dependencias que no se mencionan. También puede proponer una primera versión de la tabla de riesgos a partir de la evidencia.
Qué no debe decidir. La prioridad por riesgo, el valor de cualquier TTL o umbral, la tolerancia de crédito, la clasificación de un BLOCKED como OUT, y la aprobación del Sprint. Esas decisiones son de personas con autoridad.
Contexto mínimo. Las secciones del Sprint que se revisan, las RN y NFR citadas, la lista de ADR y la tabla de objetivos. No conviene cargar el manual completo: el agente se distrae con texto que no decide nada.
Prompt de ejemplo:
Revisá las secciones 1 a 6 del borrador del Sprint de Nexo que adjunto.
No reescribas nada. Devolvé solo problemas, en una lista con estas columnas:
id, problema, sección donde aparece, evidencia que falta.
Reglas:
- Para cada objetivo OBJ-n, indicá si existe una prueba o demo que lo demuestre y citá la sección.
- Para cada decisión técnica, indicá qué ASR, RN o riesgo la origina. Si no hay origen, escribí "sin origen".
- Si el texto propone valores para TTL, tolerancia de crédito o umbrales de latencia, marcalos como sospechosos y no los completes.
- Si un dato no está en la evidencia, devolvelo como BLOCKED con la persona que lo resuelve, si aparece en el documento.
Cómo revisar la salida. Verificá cada cita contra el documento: si el agente cita una sección que no existe, la revisión está rota y no sirve. Cualquier número nuevo que aparezca en la salida tiene que tener fuente o volver a BLOCKED. Y la lista de problemas es un insumo para tu criterio, no una aprobación: el gate exige que una persona pueda defender cada decisión.
Para llevarte
- Un Sprint de Arquitectura se dimensiona por costo de reversión. Si la decisión es barata de cambiar, no necesita Sprint.
- Cada sección del Sprint responde una pregunta concreta. Si no responde ninguna, se recorta.
- La autoridad de un dato es una propiedad que se prueba, por ejemplo con AC-04, y no una intención escrita en un documento.
- Un contrato de fallo declara qué efecto ya ocurrió, qué ve el usuario y cómo se reintenta sin duplicar. Sin clave, no hay reintento seguro.
- Un riesgo sirve cuando tiene una señal observable y un dueño. Un BLOCKED sin dueño se olvida.
- Los slices son unidades de valor que atraviesan el sistema. Los checkpoints A a F son pasos internos de cada uno, no entregables.
¿Cómo valoras el contenido técnico de esta lección?
Tu feedback nos ayuda a mejorar los laboratorios prácticos de Eje Z.